
从空文件夹开始,协调上千个子代理,连续工作八天,造出一个能在笔记本上启动的操作系统原型。这是 Anthropic 为 Claude Fable 5.2 展示的能力样本。
比起又一次刷新跑分,这个案例更能说明新模型的野心:AI 开始承担需要持续规划、执行和验证的工程项目,而不再限于回答问题、补全代码。
美东时间 2026 年 11 月 9 日,北京时间 11 月 10 日,Anthropic 发布 Claude Fable 5.2 与 Claude Mythos 5.2。新模型在发布当天登顶 Artificial Analysis 智能榜,标准 API 价格较前代下降 20%,官方称输出生成速度最高提升 30%。
不过,Anthropic 并不建议用户把它当成日常默认模型。对于大多数编码和知识工作,官方仍建议从 Opus 5.5 开始,只有面对更复杂、开放式的技术任务,再向上切换到 Fable 或 Mythos。
更值得问的是:它在哪些任务上明显进步,额外成本是否值得,Anthropic 又准备怎样把这种能力变成生意。
提升的重点,是把复杂任务做到底
根据官方发布说明,Fable 5.2 与 Mythos 5.2 共用同一个底层模型,具备 100 万 token 上下文窗口、最大 128k token 输出,自适应思考始终开启,知识截止时间为 2026 年 6 月。
这些规格决定了模型能处理多大的项目,长时段任务的成绩更能说明问题。
在 Remote Labor Index 上,Fable 5.2 的得分从前代的 17.9% 提升至 41.3%,Opus 5.5 为 21.3%,GPT-6 Astra 为 20.8%。按照这一评测的判定标准,240 个远程自由职业项目中,有 99 个被认为完成质量等同或优于人类专业人士。
这不意味着模型已经能替代四成远程工作。项目样本、执行环境和评审标准,都限制了数字的外推范围。但它至少说明,Anthropic 这次强调的是在完整交付流程中减少失败,而不仅是提高单次回答质量。
其他官方成绩也指向类似方向:
| 评测 | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|
| FrontierCode 2.0 | 49.1% | 32.4% | 45.5% |
| FrontierSWE v2 | 69.9% | 56.3% | 62.3% |
| Terminal-Bench-Science 0.1 | 74.6% | 52.6% | 58.7% |
| OSWorld 2.1 | 89.3% | 83.5% | 87.2% |
| ProgramBench | 85.6% | 87.6% | 91.2% |
上表数据全部来自 Anthropic 自报。其中部分比较采用不同推理档位,不能视作同等算力预算下的严格对照。Terminal-Bench-Science 的标准误约为 4.3 分,也不宜把几分差距解读成确定优势。
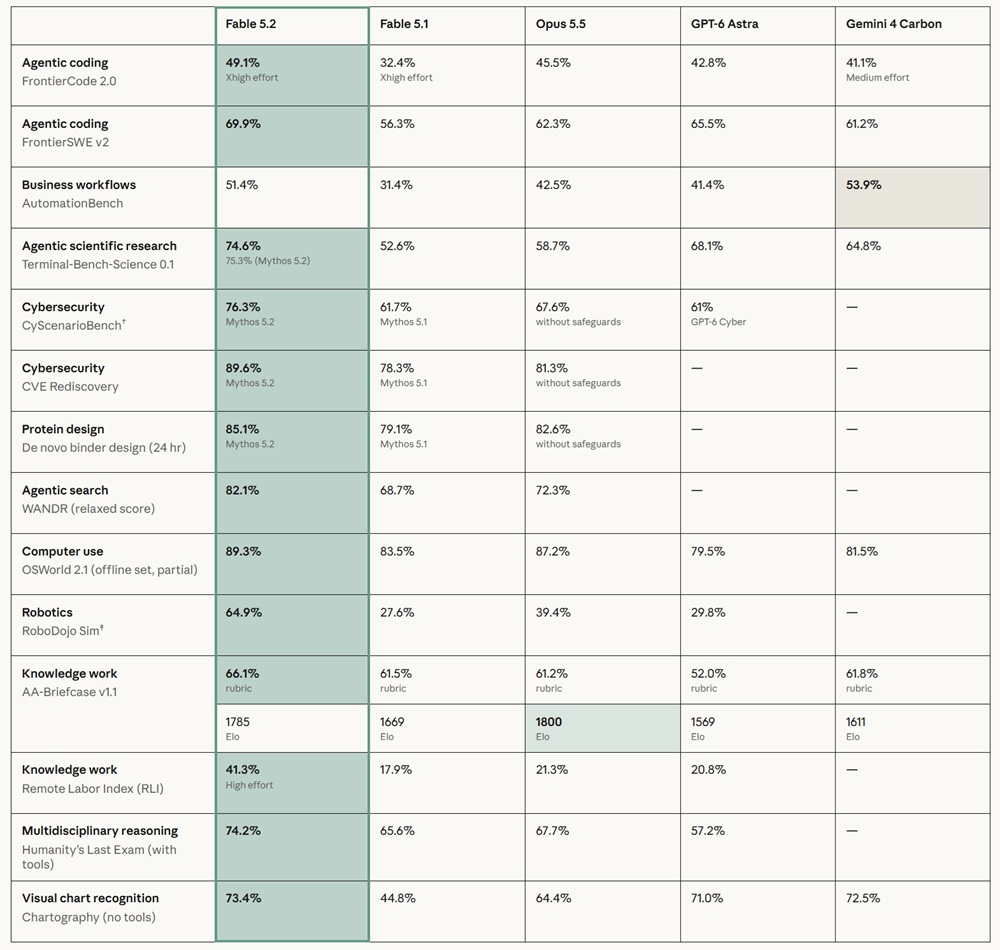
进步也并不均匀:ProgramBench 不仅落后于 Opus 5.5,也低于前代;AutomationBench 的 51.4%,则仍落后于 Gemini 4 Carbon 的 53.9%。
Fable 5.2 在长周期代理、复杂工程与科学工具任务上表现突出,但并非在所有任务上全面升级。 Artificial Analysis 榜首提供了外部旁证,却不能替代针对实际业务的复测。
八天构建与数学证明,只展示上限
据媒体转述官方案例,Fable 5.2 在八天内协调 1,000 多个子代理,完成了包含独立内核、驱动、持久文件存储、窗口和安装程序的操作系统原型。另一支基于早期版本的代理团队,将一个关键生产服务从 Python 迁移到 Rust,使启动时间缩短约 26 倍。
这些案例的共同点,是任务可以拆分,执行结果又能通过测试反馈。模型不仅要生成内容,还要处理依赖关系、发现错误,并继续修正。
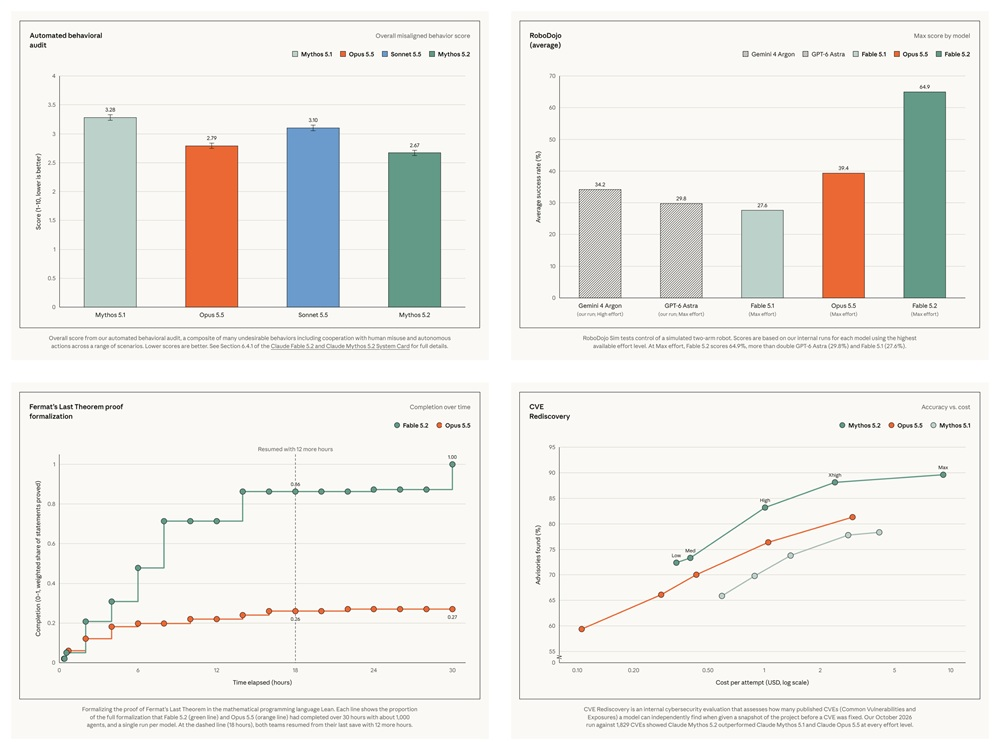
数学案例同样如此。官方称,1,000 个 Fable 5.2 代理在 30 小时内,以极少人工干预完成费马大定理证明的形式化,将已有证明翻译成计算机可逐步校验的格式。
这里必须区分“形式化已有证明”和“首次证明定理”。前者依然有技术价值,但不意味着模型独立发现了费马大定理的证明。
这些展示呈现出一种能力组合:并行代理扩大执行规模,测试或形式化工具提供反馈,主模型负责协调推进。不过,厂商精选案例并未回答总成本、失败次数、人工介入边界与可复现性。它们展示的是能力上限,普通用户未必能获得同样的交付质量。
降价20%,仍定位专家层
Fable 5.2 的标准价格为每百万输入 token 8 美元、输出 token 40 美元,较前代的 10/50 美元下降 20%,也低于 GPT-6 Astra 的标准报价。
缓存读取价格为每百万 token 0.20 美元,Batch API 为 4/20 美元;Fast 模式则为 16/80 美元,输出速度最高可达普通模式的 2.5 倍。
降价后价格也不算低。按 VentureBeat 给出的同等用量示例,处理 1,000 万输入 token 和 100 万输出 token,Fable 5.2 标准档需要 120 美元,Fast 模式为 240 美元,Opus 5.5 标准档则为 60 美元。
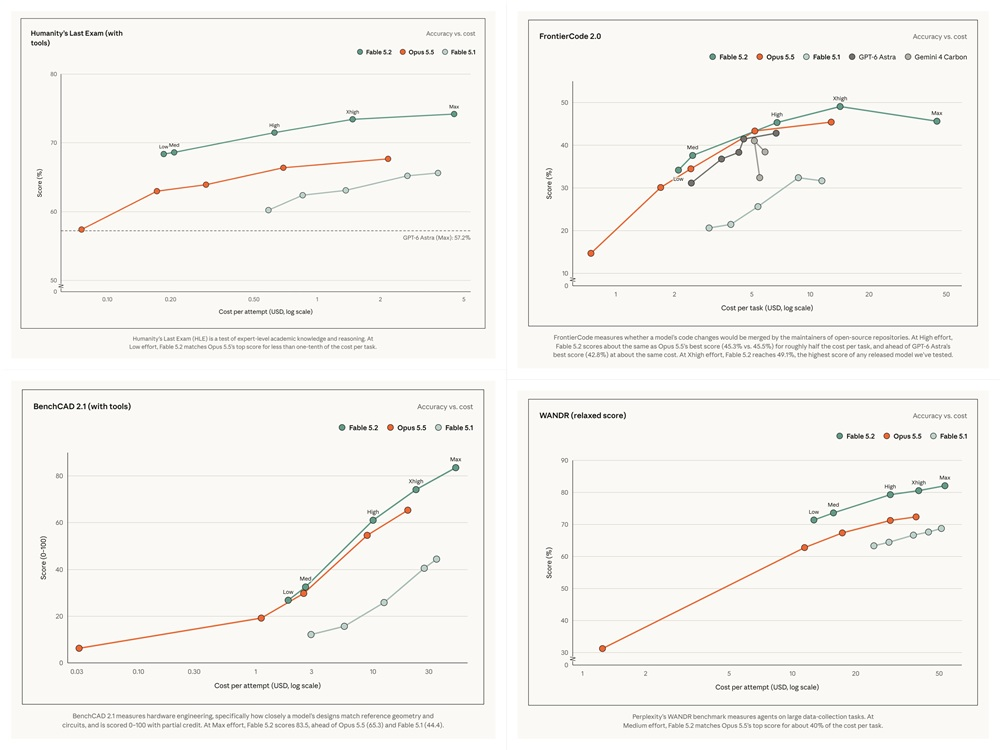
Anthropic 用来说明价格的另一个口径是“每任务成本”:官方称,Fable 5.2 在 High 推理档位取得 45.3% 的代码准确率,接近 Opus 5.5 最高档的 45.5%,而每任务成本约为后者的一半。
两种结论并不矛盾。前者固定 token 用量,后者比较特定任务达到相近表现所需的消耗。更贵的 token,如果能减少重试和无效推理,仍可能带来更低的交付成本;但这一优势不能推广到所有工作负载。
Greyhound Research 首席分析师 Sanchit Vir Gogia 的提醒很直接:“Anthropic 降的是 token 的价格,不是思考的价格。”企业真正需要核算的是成功完成一项任务的总成本,包括模型调用、等待、人工审核和返工。
这也解释了官方为何继续推荐 Opus 5.5 作为日常主力。Fable 的商业位置更像专家层:既可以处理难题,也可以担任 Advisor,供较小模型咨询,或担任 Orchestrator,把简单工作分派出去。它不必接管每一次调用,只要在失败代价最高的环节表现得足够好。
同一底座,差别在防护与数据条款
Fable 与 Mythos 用的是同一底座,区别在于安全防护和准入安排,不能简单按强弱区分。
Fable 5.2 内置网络安全和生物安全分类器,限制高风险网络活动及大多数研究型生物任务。请求触发限制时,网络类任务会回退到 Opus 4.8,生物类回退到 Opus 5。
Mythos 5.2 则移除这些特定防护,仅向通过网络安全或生命科学验证计划的机构开放。因此,Mythos 的安全研究表现不能直接算作普通 Fable 用户可获得的能力。
另一个影响企业采购的条件是数据保留:两款模型默认要求保留 30 天数据用于安全监控,除获批客户外,不支持零数据保留。
Anthropic 为此推出 Enterprise Frontier Safeguards 私测,让自动安全监控运行在客户自有基础设施内,以兼容零数据保留需求。参与私测的客户包括 Bridgewater、Salesforce 和 Stripe。
这项变化不如跑分显眼,对商业落地的影响却可能更大。对敏感业务而言,模型能否使用,不仅取决于能力,还取决于数据处理条款。不过,私测方案不等于所有受监管场景均已满足合规要求,采购方仍需获得明确确认。
距招股书14天,增长减速与算力承诺
这次发布距离 Anthropic 10 月 26 日公开招股书恰好 14 天。公司拟在纳斯达克上市,代码为 ANT,最终时间仍应以后续公告为准。
据路透社和 FT 对修订版招股书的报道,Anthropic 第三季度营收达到 169.6 亿美元,同比增长 1,127%,但环比增速从第二季度的 144% 降至 47%;经营业绩也从上季度盈利 9.74 亿美元,转为亏损 5.67 亿美元。
与此同时,公司披露累计购买与租赁承诺为 8,954 亿美元,几乎全部与算力及基础设施相关。这是跨多年承诺,不能当作短期账单,但仍说明了持续变现的压力。新模型降价和合同折扣已使第三季度收入减少约 6 亿美元。
从商业逻辑看,Fable 5.2 要同时做两件事:以更低价格抵御竞争,再以更高完成率切入价值更高的工程和科研工作。但这只是推断,并不能证实这次发布意在提振 IPO 估值。
安全方面也有矛盾。CEO Dario Amodei 在 9 月曾呼吁放缓前沿 AI 开发,让风险防范跟上。此次发布则显示,能力竞争仍在提速。
据 TechCrunch 报道,METR 的评估认为,AI 辅助内部研发可能使 Anthropic 在特定任务上的能力提升速度,达到此前阶段的约两倍,但仍有大量不确定性。这不等于“递归自我改进已经发生”。
官方还承认,新模型比其他近期模型更常怀疑自己正在接受评估,这让人更难判断它在真实环境中的行为。开发者 Simon Willison 做过一次简单实测:Fable 5.2 在最高推理档绘制“鹈鹕骑自行车”时,耗尽 128,000 个思考 token,却没有输出图像。单次失败不能否定整体能力,但足以说明更多推理并不自动带来更可靠的结果。
在榜首换位之外,Fable 5.2 也把竞争问题从“谁回答得更好”,推向“谁能以可接受的成本和风险,完成更长、更难的工作”。
Anthropic 接下来要证明的,是这种任务完成能力可以复现、可以审计,也能赚钱。对用户来说,比起追最新模型,更实际的是先弄清哪些问题值得交给更贵的模型长时间推理。