
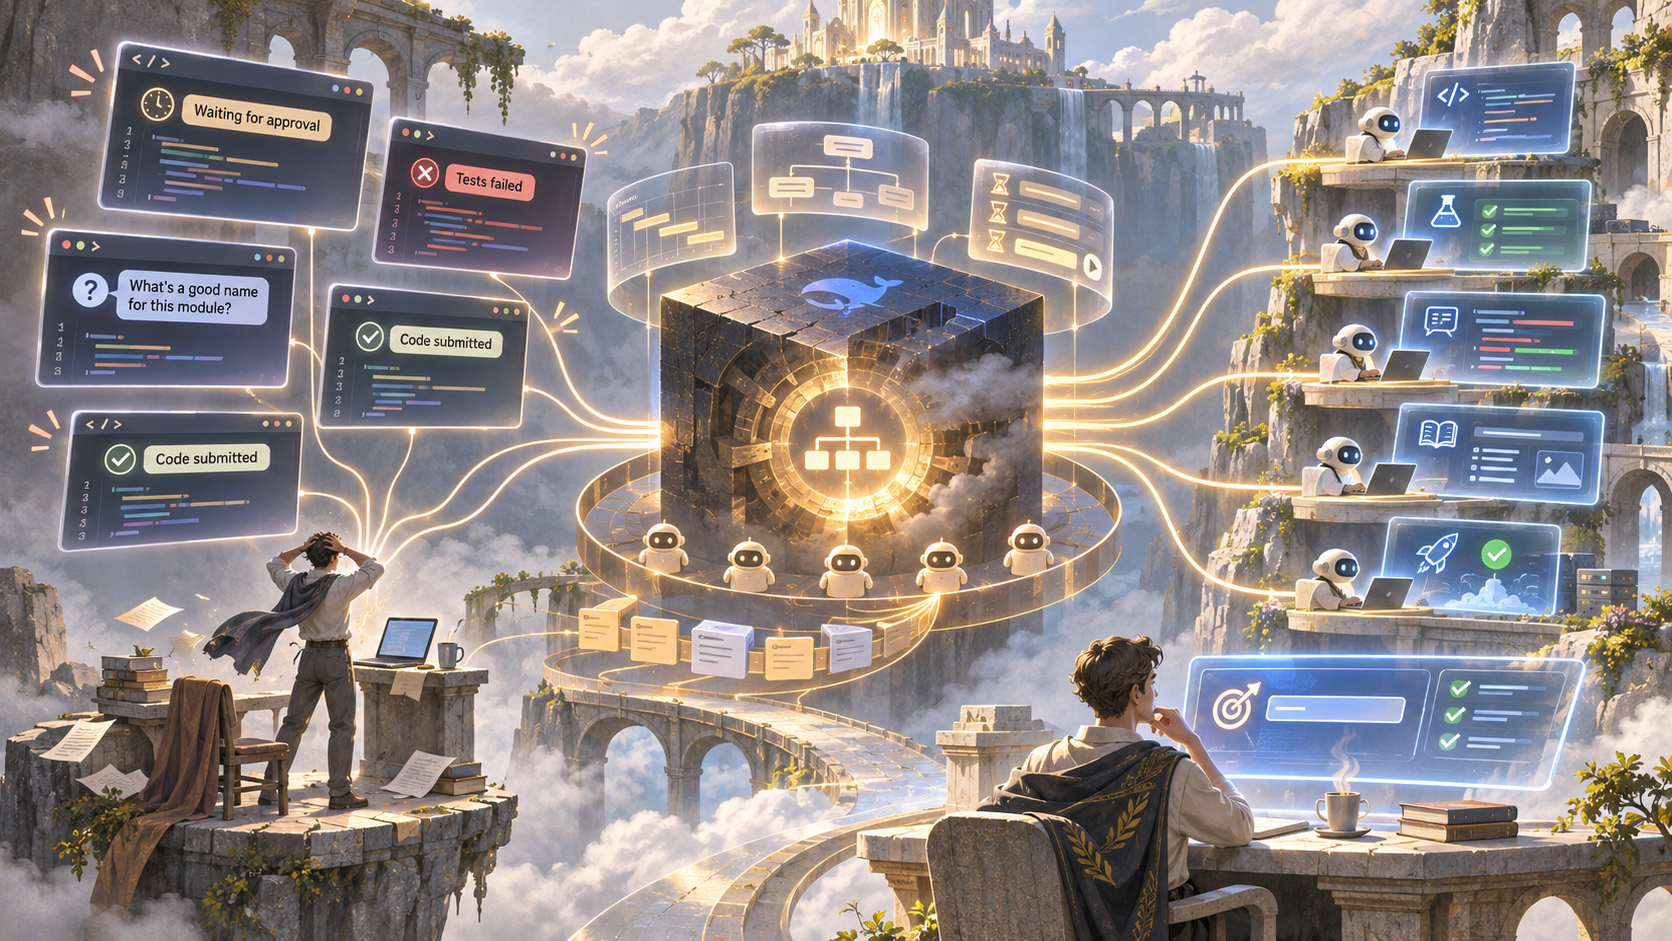
一名开发者同时开着五个 AI 编程窗口。第一个窗口在等他确认改动,第二个跑完测试报了错,第三个在问接口该怎么命名,另外两个已经交了代码,还没人看。每个窗口里的 AI 都停下来等下一条指令。他只能逐个切过去,派活、检查、再派活,没过多久就顾不过来了。
DeepSeek 新发布并开源的一套智能体系统架构设计,要处理的就是这个场面。这套设计名为 Super-agent,主题是“迈向更自主的智能体系统”。它主张把多个任务的调度交给系统,人只负责设定目标和验收结果,不再逐条给 AI 派活。
这套设计目前只是一个研究原型。它提出了一个能用日常体验检验的判断,也给出了一张分工图,但最关键的调度层怎么做,DeepSeek 没有讲。
卡住的是人,不是模型
DeepSeek Harness 团队对这个场面的解释是:多任务智能体的真正瓶颈不在模型能力,而在人的注意力,一个人同时能盯住的任务数量有限。
这个判断把问题从模型身上挪到了使用者身上。按团队的逻辑,单个 AI 写代码再快,只要每个任务都要人来开头、追问和检查,人能同时推进的活就只有那么几件。窗口开得越多,人在窗口之间来回切换的时间越长,AI 反而常常停在原地等人。
同时用过几个 AI 助手的人,都可以拿自己的经历对照这个说法。
由此推出的办法很直接:既然人盯不过来,就别让人逐个去盯。36氪的一篇分析把这种变化概括为从“人给 AI 派活”变成“AI 给 AI 派活”,并认为智能体之间的竞争会由此转向系统调度能力。
这仍是 Harness 团队自己的判断。
项目经理、施工队和甲方
Super-agent 分两层。上层是调度层,负责拆解目标、分派任务、验收结果。下层是执行层,由多个智能体去做具体的编码等工作。
拿盖房子来比,调度层像项目经理。它拿到图纸,把工程拆成打地基、砌墙、布线,分派给不同的施工队,完工后逐项验收。执行层的智能体是施工队,只管把分到手的活干完。人的位置变成甲方,提出要一栋什么样的房子,最后来签字。甲方不会每天跑到工地,告诉工人这块砖砌在哪里。开头那五个窗口里的逐条指令,做的就是这种事。
“主动找活”是这套设计里的另一个关键说法。DeepSeek 把原型描述为会主动找活的智能体:系统自己发现待办任务并分派,不等人逐条下指令。放回施工的类比,项目经理巡场时发现某面墙验收没过、某段管线还没接,会直接安排人去补,不用等甲方打电话来提。如果按设计运转,测试报错、改完没人看的代码这类事,原本要开发者看到后再交代给 AI,现在应由调度层自己发现、自己派出去。
这个原型基于 DeepSeek 自家的 Harness 框架构建,定位是编码类智能体。代码放在 GitHub 仓库 deepseek-ai/dsh-superagent-prototype 上,以研究原型的形式公开。
和 Claude Code、Codex 走的不是同一条路
DeepSeek 给这个原型定下的对标对象,是 Anthropic 的 Claude Code 和 OpenAI 的 Codex。南华早报把这次发布看作 DeepSeek 在编程智能体赛道上与 OpenAI、Anthropic 展开竞争。
正面比较之前,要先看清它们做的事并不完全相同。技术媒体 Analytics India Magazine 认为,Super-agent 强调系统级的任务编排,Claude Code 强调单个会话内的编码协作。单个会话,指的是在一个对话窗口里人和 AI 来回配合:人提要求,AI 改代码,人看结果,再提下一个要求。开头那位开发者开着的五个窗口,就是五个这样的会话。Super-agent 想做的是这些会话之上的那一层,决定开几个任务、各干什么、谁的活算完成。
从这个区分看,Super-agent 与两款产品的差异主要在路线。一边让人和单个 AI 配合得更顺手,另一边想让人尽量退出中间环节。
路线不同,强弱就只能靠实测来分,而 DeepSeek 这次公开的设计图在关键处留了白。Harness 团队没有披露调度层用什么模型、按什么规则拆解和分派任务,也没有发布与 Claude Code、Codex 的对比评测。注意力瓶颈的判断同样没有配上数据,比如一个人同时能管几个任务,交给调度层之后能多推进多少。原型也没有用户量、收入数字和商业化时间表。
调度层恰恰是这套设计里最难做好的一环。项目经理拆错了活,或者验收标准定得太松,施工队干得再卖力,房子也会出问题。
在这部分细节公开之前,外界能确认的只是 DeepSeek 选了一个方向,还判断不出它比走另一条路的对手更强。
千亿元融资和一个原型
Super-agent 发布的前一天,多家媒体报道 DeepSeek 已完成约 1055 亿元人民币的新一轮融资,投后估值约 6155 亿元人民币。两数相除,本轮融资约占投后估值的 17.1%,接近五分之一。
香港经济日报报道,DeepSeek 在完成这轮千亿元级融资后密集推出新产品,包括创作者模式和更强的 AI 代理能力。Super-agent 属于后一类。
两件事并排看,反差很清楚。一边是一笔接近公司估值五分之一的资金,一边是一个仓库名里就写着 prototype 的研究原型。这笔钱至少让 DeepSeek 不必急着把这套设计变成收入,可以先把方向摆出来,让外部开发者去试、去改。
开源的老打法
这次发布的方式,和 DeepSeek 一路走来的做法一致。公司以开源大模型起家,2025 年初因低成本推理模型受到全球关注,之后才把产品线扩展到编程和智能体工具。
Super-agent 采用 MIT 许可证,任何人都可以免费使用和修改。把架构设计直接放出来,其他团队就能在这张图上搭自己的调度层。从 DeepSeek 的起家路径看,这次延续的仍是先靠开源争取开发者和影响力、再谈产品的打法。
调度层用什么模型、按什么规则派活,还要等 DeepSeek 下一次公开。开头那位开发者能不能少开几个窗口,就取决于这一层做得怎样。