行业深度/2026/10/14/8 分钟阅读
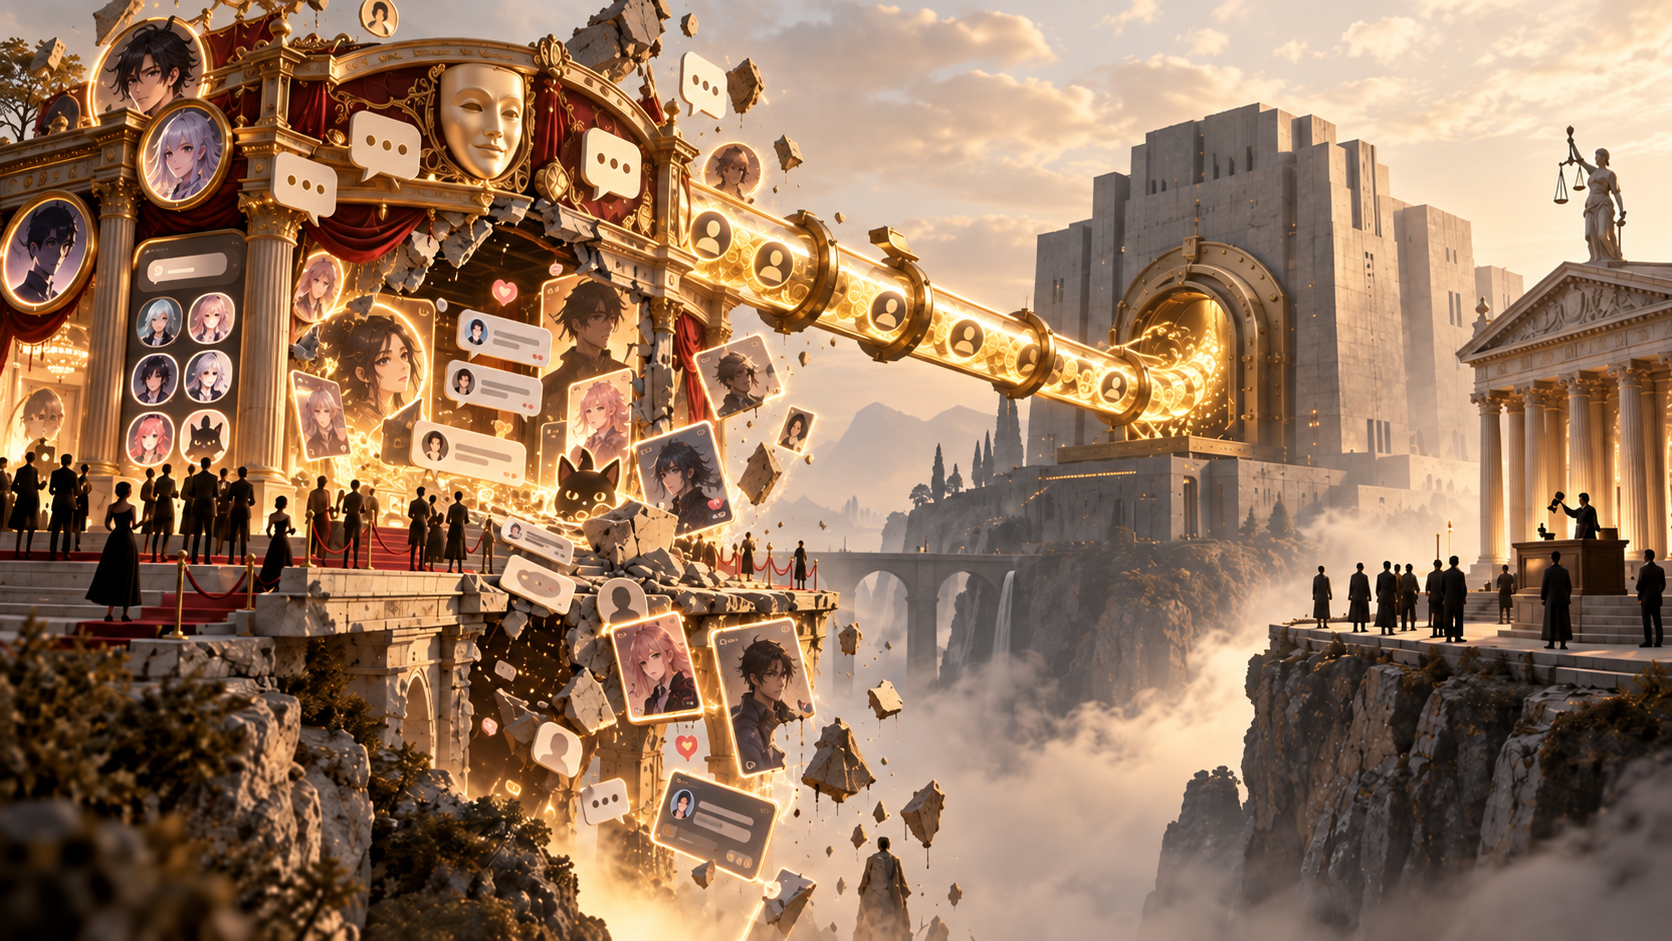
Character.AI破产:谷歌买走了创始团队,留下的是账单和官司
27亿美元去了哪里?一家月活约1200万、活跃用户每天平均聊天120分钟的明星公司,为什么走到需要法院监督出售的地步?为什么28个潜在买家只产生一份不可执行的提案,最终只剩迪士尼肯出价?答案分两半:谷歌买走的是人和能力,不是公司的未来;此后这家公司独自面对的,是收入追不上推理成本的账目,和一层无法定价的法律风险。
阅读全文
聚焦 AI 工具、模型、Agent、内容生产和 Web3 应用,用教程、评测、案例和对比文章帮你更快判断工具怎么选、怎么用。
27亿美元去了哪里?一家月活约1200万、活跃用户每天平均聊天120分钟的明星公司,为什么走到需要法院监督出售的地步?为什么28个潜在买家只产生一份不可执行的提案,最终只剩迪士尼肯出价?答案分两半:谷歌买走的是人和能力,不是公司的未来;此后这家公司独自面对的,是收入追不上推理成本的账目,和一层无法定价的法律风险。
阅读全文2026年9月,一个不会聊天、不能写文章、专门做“判断”的AI模型,在发布24小时内覆盖了Vercel约13%的付费团队。它为什么能这么快被开发者接受,它到底解决了什么问题,又有哪些做不到的事。
9月3日,OpenAI 发布 GPT-6 Astra,自称“世界上最智能、对齐程度最高的模型”,Greg Brockman 在记者简报会上以“欢迎来到 AGI 时代”收尾。官方基准上的代际跃迁、第三方复测的持平、系统卡里承认的思维链监控退步,加上发布前夜三家头部厂商相继宕机,让这句口号的成色值得逐项核对。
孙正义否定马斯克的太空数据中心构想,直指AI决战在陆地。本文拆解AI算力基建的真实成本结构,以71%硬件折旧对比9%电力成本,并揭示太空真空散热带来的百吨载荷灾难及毫秒级通信延迟对微秒级训练的致命打击。算力选址终局为何只能在陆地?投资与产业观察者需要看清这笔硬核工程账。
本指南解析豆包大模型当前能力与适用场景,对比通义千问、文心一言等国产主流大模型在上下文长度、价格计费上的差异。适合需要选型或接入大模型 API 的普通用户与企业开发者,帮你理清怎么用、多少钱、如何避坑。
智谱在发布 GLM-5.2 当天没有给出任何 Benchmark 跑分表,这在 2026 年的模型发布节奏中极不寻常。文章围绕这一反常信号,将 GLM-5.2 放进 GPT-5.5、Claude Fable 5 和 Kimi K2.7 Code 构成的国际坐标系中,用前代数据 GLM-5.1 的 SWE-Bench Pro 58.4% 和知乎实测反馈替代缺失的跑分,回答一个核心问题:在没有官方数据的情况下,这款模型到底值不值得进入选型考量。
本文以 OpenAI 总裁回归为线索,深度剖析了 AI 编程工具 Codex 与 Claude Code 的核心差异:前者适合长时连续编码且 Token 消耗更低,后者在复杂多文件重构中准确率更高。同时文章拆解了 OpenAI 整合产品线打造 AI 智能体超级应用的战略逻辑,为开发者选型与工作流优化提供实战参考。
本文详细记录了 OpenAI Codex 最新上线的移动端远程控制功能配置流程,并深度对比了其与 Claude Code 在同步体验、稳定性及账号风控上的差异。作者结合高频出差场景,实测了 Codex 的 Computer Use、内置浏览器标注、Chrome 扩展及原生生图等核心更新,为开发者提供了跨设备 Vibe Coding 的完整工作流参考与工具选型建议。
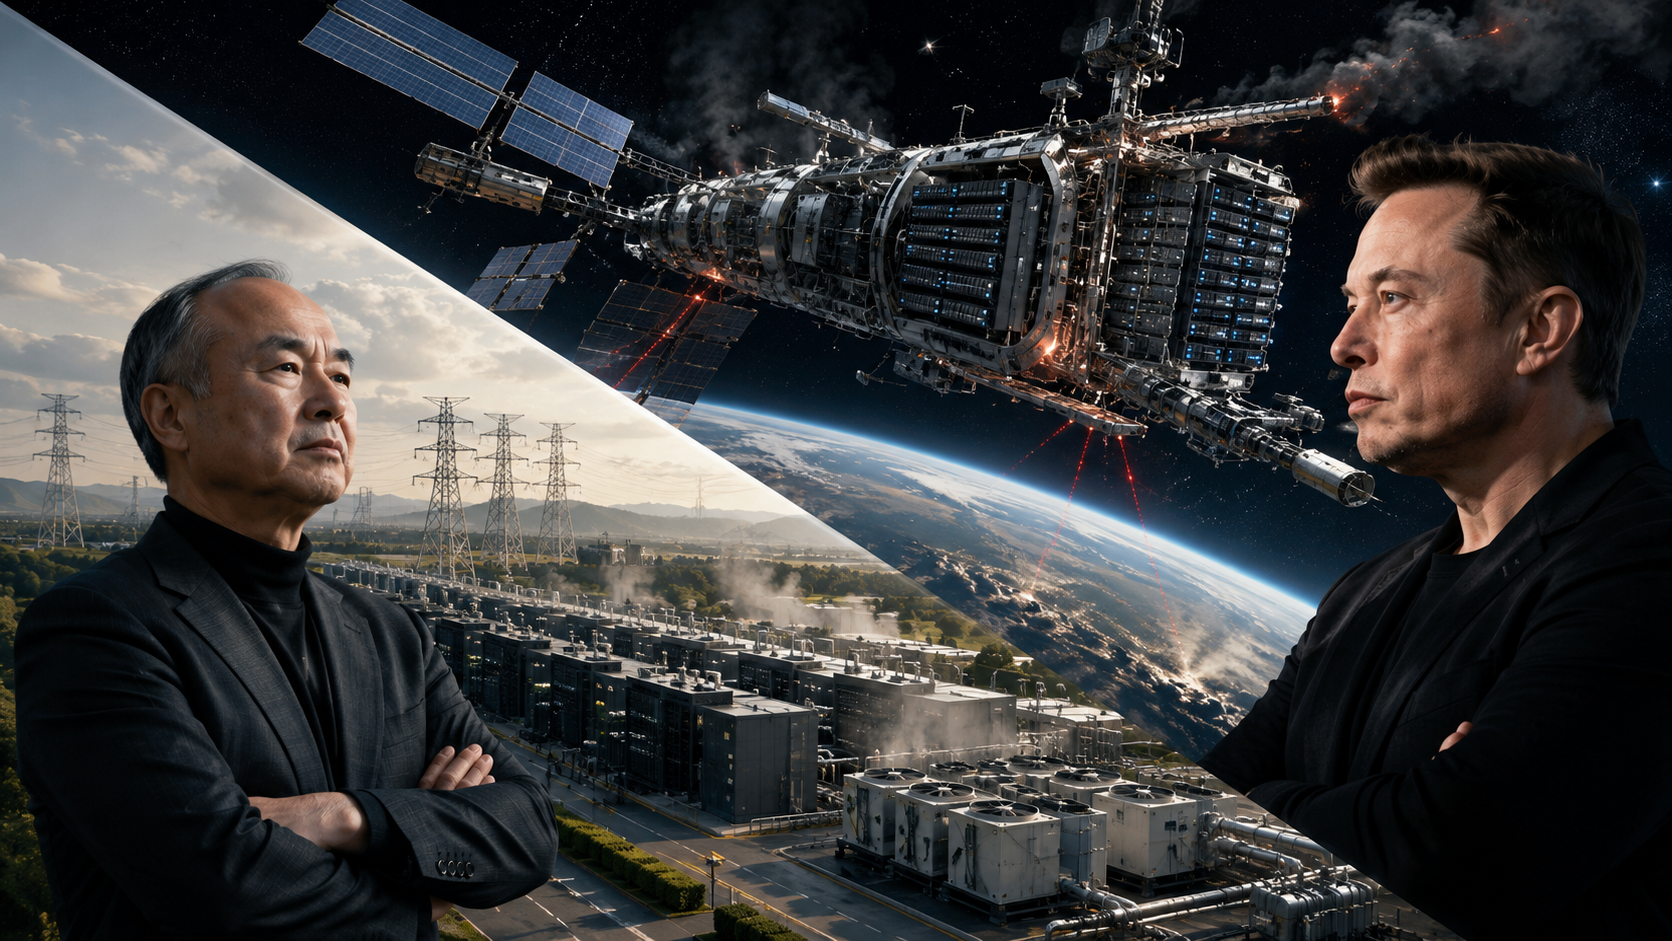
孙正义否定马斯克的太空数据中心构想,直指AI决战在陆地。本文拆解AI算力基建的真实成本结构,以71%硬件折旧对比9%电力成本,并揭示太空真空散热带来的百吨载荷灾难及毫秒级通信延迟对微秒级训练的致命打击。算力选址终局为何只能在陆地?投资与产业观察者需要看清这笔硬核工程账。
本指南解析豆包大模型当前能力与适用场景,对比通义千问、文心一言等国产主流大模型在上下文长度、价格计费上的差异。适合需要选型或接入大模型 API 的普通用户与企业开发者,帮你理清怎么用、多少钱、如何避坑。
智谱在发布 GLM-5.2 当天没有给出任何 Benchmark 跑分表,这在 2026 年的模型发布节奏中极不寻常。文章围绕这一反常信号,将 GLM-5.2 放进 GPT-5.5、Claude Fable 5 和 Kimi K2.7 Code 构成的国际坐标系中,用前代数据 GLM-5.1 的 SWE-Bench Pro 58.4% 和知乎实测反馈替代缺失的跑分,回答一个核心问题:在没有官方数据的情况下,这款模型到底值不值得进入选型考量。
本文以 OpenAI 总裁回归为线索,深度剖析了 AI 编程工具 Codex 与 Claude Code 的核心差异:前者适合长时连续编码且 Token 消耗更低,后者在复杂多文件重构中准确率更高。同时文章拆解了 OpenAI 整合产品线打造 AI 智能体超级应用的战略逻辑,为开发者选型与工作流优化提供实战参考。
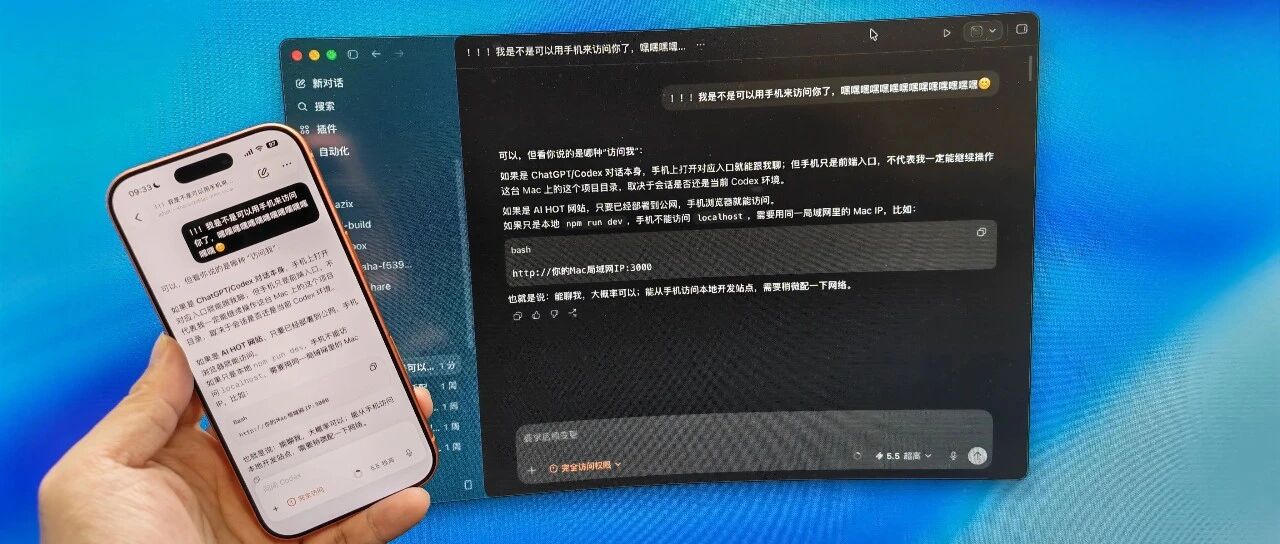
本文详细记录了 OpenAI Codex 最新上线的移动端远程控制功能配置流程,并深度对比了其与 Claude Code 在同步体验、稳定性及账号风控上的差异。作者结合高频出差场景,实测了 Codex 的 Computer Use、内置浏览器标注、Chrome 扩展及原生生图等核心更新,为开发者提供了跨设备 Vibe Coding 的完整工作流参考与工具选型建议。